터보퀀트 KV 캐시 6배 압축과 HBM 수요 판단 기준
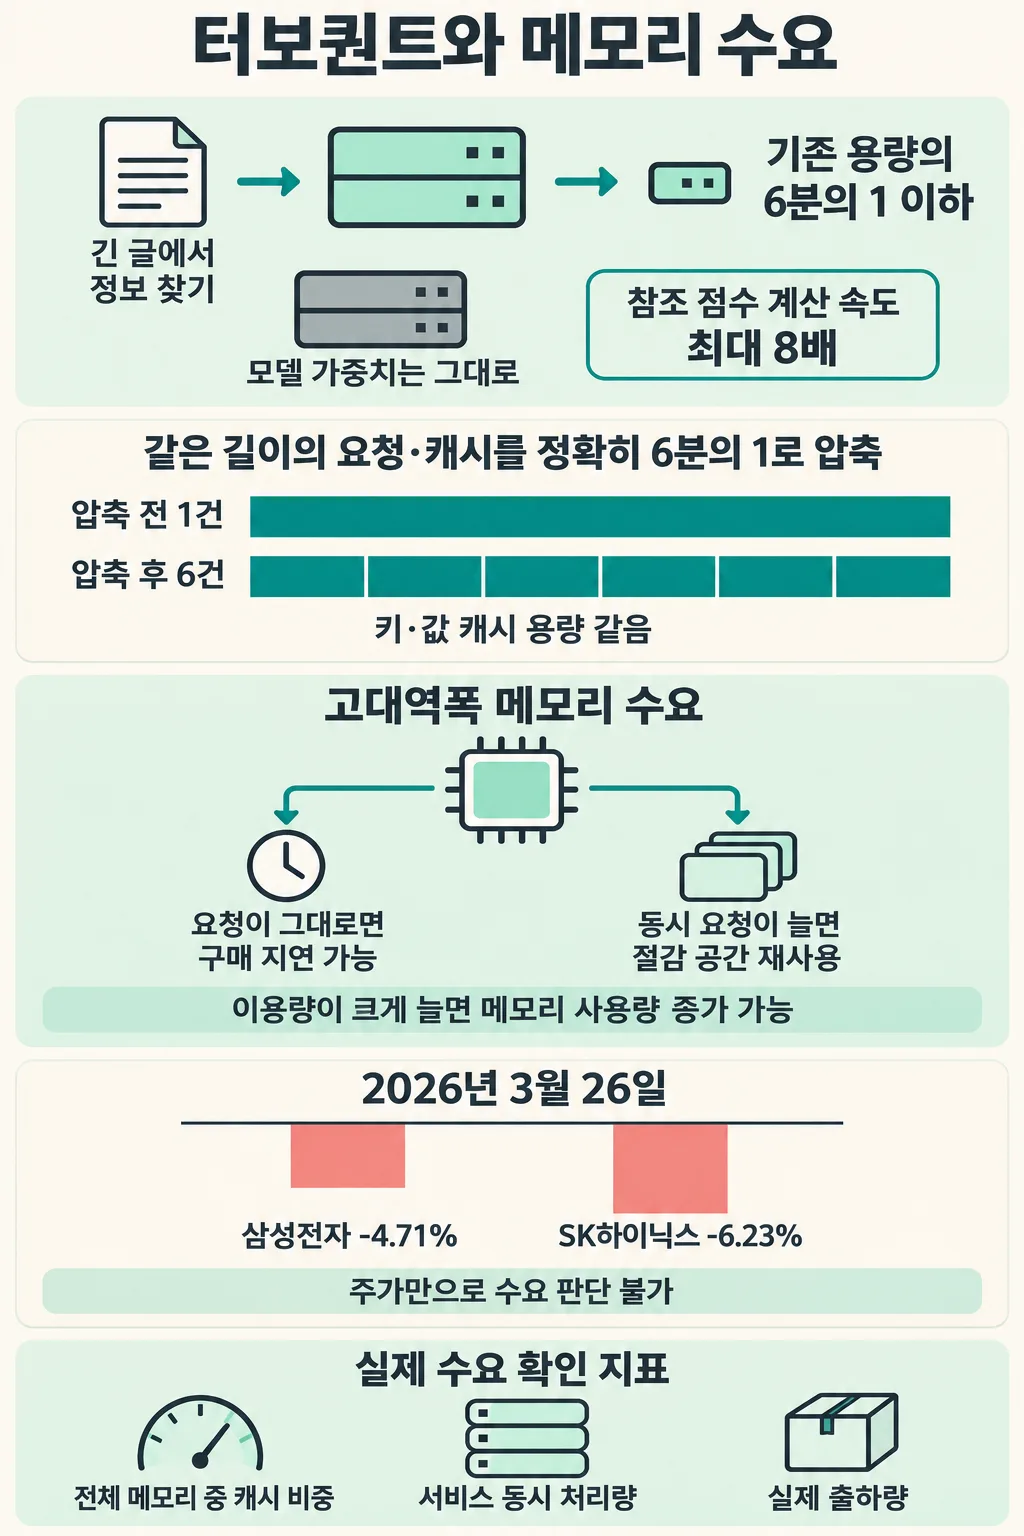
Google은 긴 글에서 정보를 찾는 실험에서 KV 캐시를 기존의 6분의 1 이하로 줄였습니다. HBM 구매 수요에 미칠 영향은 캐시가 차지하던 비중과 압축 후 동시에 처리할 요청이 얼마나 늘어나는지에 달려 있습니다.
- Google이 2026년 3월 발표한 6배 이상 압축 수치는 언어 모델이 답을 생성할 때 쓰는 KV 캐시를 측정한 결과입니다.
- 캐시를 정확히 6분의 1로 줄인다면, 같은 길이의 요청 6건이 쓰는 캐시 용량은 압축 전 1건과 같습니다.
- 2026년 3월 26일 삼성전자는 전 거래일보다 4.71%, SK하이닉스는 6.23% 하락했습니다.
- HBM 수요의 변화를 확인하려면 서비스의 동시 처리량과 메모리 업체의 실제 공급 물량을 함께 봐야 합니다.
Google의 터보퀀트(TurboQuant)는 실험에서 AI 답변 생성에 쓰는 KV 캐시를 기존의 6분의 1 이하로 줄였습니다. 요청 한 건에 필요한 메모리는 줄어듭니다. 전체 고대역폭 메모리(HBM) 수요는 동시에 처리할 요청이 얼마나 늘어나는지에 달려 있습니다.
압축 수치는 2026년 3월 24일 Google Research 발표에서 가져왔으며, 주가는 3월 26일 종가를 기준으로 했습니다.
터보퀀트가 압축하는 KV 캐시란 무엇입니까?
KV 캐시는 언어 모델이 앞선 문맥을 다시 참조할 때 쓰는 임시 저장 공간입니다. 모델은 글을 토큰이라는 단위로 나누어 처리합니다. 각 토큰에서 계산한 키와 값(KV)을 보관하면 다음 토큰을 생성할 때 그 계산을 되풀이할 필요가 없습니다.
대화가 길어질수록 보관할 키와 값도 늘어납니다. 터보퀀트는 이 숫자들을 더 적은 비트로 표현합니다. 이를 양자화라고 합니다. 모델이 학습으로 얻은 가중치는 캐시를 압축한 뒤에도 메모리 공간을 차지합니다.
6배 압축과 8배 속도는 무엇을 측정했습니까?
Google이 발표한 두 배수는 각각 저장 공간과 특정 계산의 속도를 나타냅니다. 2026년 3월 24일 Google Research의 실험 설명에서 두 수치의 비교 대상을 확인할 수 있습니다.
| 발표 수치 | 실험 조건 | 측정한 결과 |
|---|---|---|
| 기존 용량의 6분의 1 이하 | 긴 글 속에 숨긴 정보를 찾는 과제 | 정답을 찾는 성능을 유지하면서 줄인 KV 캐시의 크기 |
| 최대 8배 속도 | H100 GPU에서 4비트 터보퀀트 키와 비압축 32비트 키 비교 | 앞선 토큰을 얼마나 참조할지 정하는 점수의 계산 속도 |
압축 후 답변 품질
품질을 얼마나 유지하는지는 숫자 하나에 배정한 비트 수에 따라서도 달라집니다. 연구 논문에 따르면 채널당 평균 3.5비트일 때도 평가에서 답변 품질이 유지됐습니다. 평균 2.5비트에서는 품질이 소폭 낮아졌습니다. 실제 서비스의 응답 시간과 품질은 그 서비스가 처리하는 질문으로 확인해야 합니다.
계산 예시로 보는 동시 요청과 메모리 용량
캐시를 정확히 6분의 1로 줄이면 같은 길이의 요청 6건이 압축 전 1건만큼의 캐시를 씁니다. 실험에서 보고한 압축 배수의 하한인 6배를 적용한 계산입니다. 모델과 요청 길이는 같고, 각 요청의 캐시는 따로 저장한다고 가정합니다.
| 동시에 처리하는 요청 | 압축 후 전체 KV 캐시 용량 |
|---|---|
| 1건 | 압축 전 1건의 6분의 1 |
| 6건 | 압축 전 1건과 같은 용량 |
| 6건 초과 | 압축 전 1건보다 큰 용량 |
서버 전체의 절감량을 계산하려면 압축 전 캐시가 몇 바이트였는지 알아야 합니다. 위 조건에서 절약하는 공간은 원래 캐시 용량의 6분의 5입니다. 전체 메모리에서 캐시 비중이 작을수록 서버 전체의 절감률도 작습니다.
HBM 수요가 줄거나 늘어나는 조건
HBM 구매 수요는 서비스 운영사가 절약한 공간을 어떻게 쓰는지에 따라 달라집니다. HBM의 용량은 한 번에 저장할 수 있는 데이터의 양입니다. 대역폭은 일정 시간에 옮길 수 있는 데이터의 양입니다. 실험에서 측정한 캐시 용량으로 구매 물량을 계산하려면 용량과 대역폭 중 무엇이 서버 증설을 제한했는지 알아야 합니다.
| 서비스 운영 조건 | HBM 수요에 미칠 수 있는 영향 |
|---|---|
| 요청 수와 길이가 일정하고 캐시 부족 때문에 증설하려던 경우 | 기존 장비에 공간이 생겨 추가 구매를 늦출 수 있습니다. |
| 같은 장비로 더 많은 요청을 동시에 받는 경우 | 절약한 공간을 새 요청의 캐시에 쓸 수 있습니다. |
| 비용 하락으로 긴 문서를 처리하는 서비스 이용이 크게 늘어난 경우 | 늘어난 작업량이 요청당 절감분을 넘으면 전체 메모리 사용량이 커질 수 있습니다. |
효율이 높아진 뒤 이용량이 더 크게 늘어 자원의 총소비가 증가하는 현상을 제본스의 역설이라고 합니다. AI 서비스에서는 처리 비용이 낮아진 뒤 실제 이용량이 얼마나 늘어나는지가 관건입니다. 메모리 업체의 매출을 판단할 때는 출하량과 판매 가격도 따로 봐야 합니다.
3월 26일 반도체주 하락의 배경
2026년 3월 26일에는 메모리 수요 둔화 우려와 중동 정세의 불확실성이 겹쳤습니다. 한국은행은 두 요인을 모두 그날의 증시 하락 배경으로 짚었습니다. 원·달러 환율은 전날보다 7.3원 오른 달러당 1,507.0원에 주간 거래를 마쳤습니다.
| 지수 또는 종목 | 2026년 3월 26일 전 거래일 대비 등락률 | 지수 종가 |
|---|---|---|
| 코스피 | -3.35% | 5,460.46포인트 |
| 코스닥 | -2%대 | 1,136.64포인트 |
| 삼성전자 | -4.71% | 해당 없음 |
| SK하이닉스 | -6.23% | 해당 없음 |
삼성증권이 발간 시점에 집계한 유가증권시장 외국인 순매도액은 3조 1,110억 원입니다. 같은 날 기술 수출을 공시한 알테오젠은 6.28% 올랐습니다. 유상증자를 공시한 한화솔루션은 18.22% 내렸습니다. 하루 등락률만으로 터보퀀트가 각 기업의 주문에 미친 영향을 가려내기는 어렵습니다.
반도체 실적에서 확인할 지표
HBM 수요를 판단할 때는 고객이 주문한 물량과 업체가 실제로 공급한 물량을 구분할 필요가 있습니다. SK하이닉스는 2026년 4월 23일 실적 발표에서 1분기에 HBM 등 고부가 제품 판매를 확대했다고 밝혔습니다. 이 분기에는 터보퀀트의 3월 발표 이전 기간도 포함됩니다.
- 운영사가 압축을 적용한 모델과 작업을 보면 서비스 도입 범위를 알 수 있습니다.
- 메모리 절감 효과를 비교할 때는 같은 요청 길이와 동시 요청 수에서 측정한 서버 전체 사용량이 필요합니다.
- 기업의 실적 발표에서는 HBM 출하 실적과 향후 공급 계획의 대상 기간을 따로 확인할 수 있습니다.
FAQ
터보퀀트를 쓰면 HBM 칩 6개를 1개로 줄일 수 있습니까?
Google이 측정한 6배 이상 압축은 KV 캐시 용량에 적용됩니다. 필요한 HBM 칩 수를 산정하려면 모델 가중치를 포함한 전체 메모리 용량과 대역폭 요구량을 알아야 합니다.
터보퀀트로 AI 학습에 필요한 메모리도 6분의 1이 됩니까?
해당 수치는 학습을 마친 언어 모델이 긴 글에서 정보를 찾을 때 쓰는 KV 캐시의 측정값입니다. 모델을 학습시키는 데 드는 전체 메모리 절감률은 이 실험으로 계산할 수 없습니다.
최대 8배라는 수치는 답변을 받기까지 걸리는 시간에도 적용됩니까?
연구팀은 H100 GPU에서 앞선 토큰을 얼마나 참조할지 정하는 점수의 계산 속도를 비교했습니다. 답변 전체의 속도를 확인하려면 입력 처리부터 출력 완료까지 걸리는 시간을 측정해야 합니다.
캐시를 압축하면 긴 대화에서 답변 품질이 유지됩니까?
Google 연구팀은 긴 글에 숨긴 정보를 찾는 시험에서 정답을 찾는 성능을 유지했습니다. 연구 논문에서는 채널당 평균 2.5비트로 낮췄을 때 품질이 소폭 떨어졌습니다.
터보퀀트는 언어 모델의 KV 캐시 외에 어디에 쓸 수 있습니까?
연구팀은 비슷한 의미의 항목을 찾는 벡터 검색에도 터보퀀트를 적용했습니다. 이 경우에는 검색 대상의 특징을 나타내는 숫자들을 압축한 뒤 원하는 항목을 얼마나 잘 찾아내는지 평가합니다.
터보퀀트 논문은 2026년 3월에 처음 공개됐습니까?
연구진이 arXiv에 논문을 처음 게시한 날짜는 2025년 4월 28일입니다. Google Research가 연구 결과를 소개한 날짜는 2026년 3월 25일(현지시간)입니다.
3월 26일 주가 하락으로 HBM 주문 감소를 확인할 수 있습니까?
당일 주가에는 향후 메모리 수요에 대한 우려와 중동 정세가 함께 반영됐습니다. 실제 주문 변화는 고객과의 공급 계약이나 이후 분기의 HBM 출하 실적에서 확인해야 합니다.
Sources
Images