Jevは、定められた選択肢と確率を返すTypeSafe AIの判断モデルです。自然言語による判断をコードの分岐条件につなげる場合に適しています。出力形式は制限しますが、判断の正確さは保証しません。
価格は2026年9月15日の発表、限界は9月17日に確認した文書に基づきます。
Jevはどのような役割を担うモデルですか?
Jevは入力内容を読み、あらかじめ定義した質問に構造化された答えを返します。評価する内容はstateに入れます。判断基準はquestionsで定義します。返された答えは分類や優先順位の決定に使えます。
TypeSafe AIはこの方式をSystem Oneモデルと呼びます。学習方式はRLCDという名前で説明しています。これは判断確率の補正に重点を置いた強化学習です。ただし、サービスごとの正確さは別途検証する必要があります。
公式のIntroduction文書では、設計原則を次のように表現しています。
個々の質問をコードで組み合わせます
TypeSafe AI, Introduction
これは、質問ごとに1つの判断を担わせるという意味です。複数の判断の組み合わせはコードで処理します。1つのリクエストに含まれる質問は、同じ状態をそれぞれ独立して評価します。詳しい構造はTypeSafe AI Introductionで確認できます。
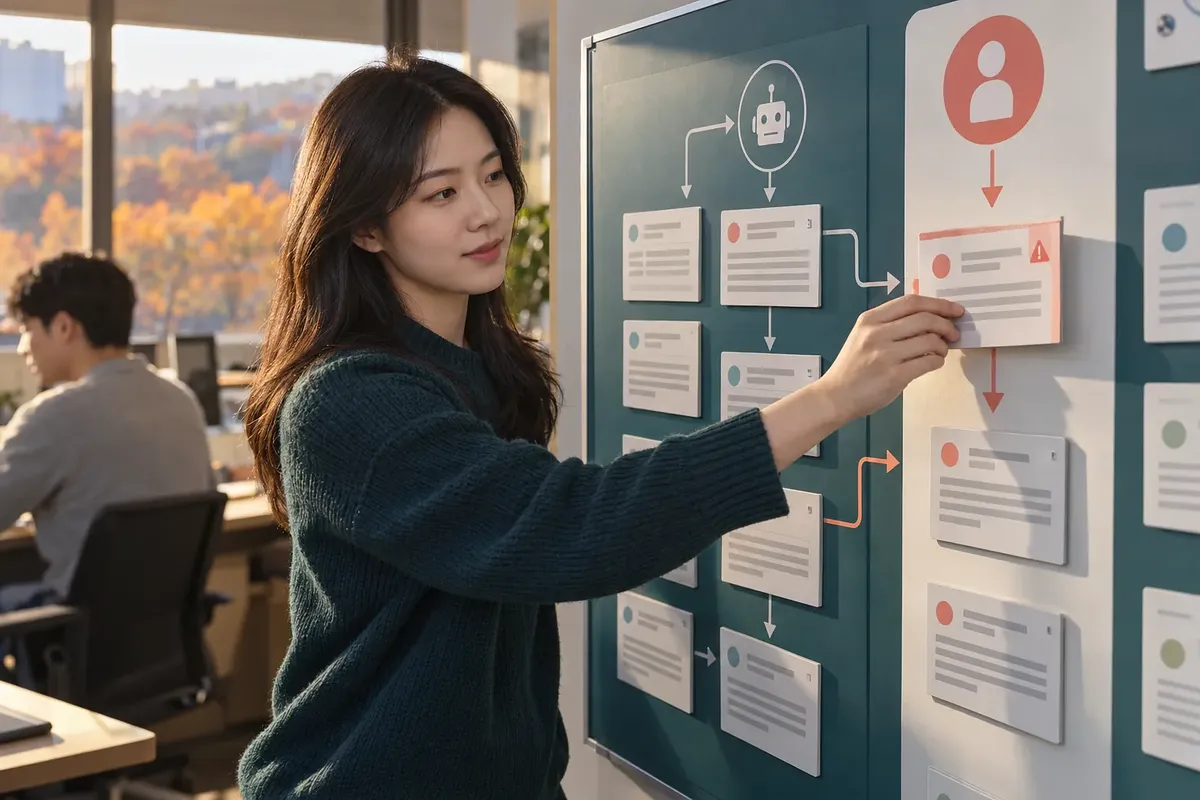
Jevの決定を自動処理と人による確認に振り分ける分岐設計が重要です。
Choice·Score·Noulの比較
質問の種類は、返された答えをコードでどう使うかに応じて選んでください。担当部署はカテゴリーを選ぶ問題です。深刻度は順序のある評価に当たります。特定の要求の有無は真と偽に分けられます。
| 種類 | 問う内容 | 主な戻り値 | コードでの利用 |
|---|---|---|---|
| Choice | 定められたカテゴリーのどれに当たるか |
choice, probabilities, confidence
|
switchによる分岐 |
| Score | 説明された段階のどの水準か |
score, probabilities, confidence
|
スコアとしきい値の比較 |
| Noul | 特定の条件が真か | noul |
確率を比較してからifで分岐 |
Choiceの選択肢はどう決めますか?
Choiceでは、1つの質問に最大255個の選択肢を指定できます。選択肢の名前と説明を併せて評価します。一覧にない入力もあり得る場合は、otherのような項目を検討してください。これは無理な分類を減らすための設計です。
Choiceは与えられた候補から1つを選びます。すべての候補が不適切かどうかも別途判断するには、質問を追加する必要があります。返される確率の合計は1です。定義と制限はChoiceの文書に記載されています。
ScoreとNoulはどう違いますか?
Scoreは、説明が付いた段階の中で位置を評価します。段階番号は0から始まります。結果は段階番号の確率加重平均です。そのため、整数ではないスコアを返すこともあります。
Noulは、条件が真である確率を0から1の間で返します。0.5付近は、真と偽の確率が近いことを意味します。不満の程度が中くらいという意味に解釈してはいけません。程度を測るならScore、有無を問うならNoulを使ってください。
通常のコード・生成モデルとの役割比較
正確な計算はコードに任せ、意味の判断だけをモデルに任せてください。文章を新たに作成する作業は生成モデルの役割です。Jevは答えの範囲が決まった判断に適しています。この区分を基準に、既存機能を置き換える範囲を決められます。
| 作業の条件 | 適した処理方法 | 理由 |
|---|---|---|
| 日付の間隔や項目数の計算 | 通常のコード | ルールに従って正確に計算できるため |
| 顧客からの問い合わせの担当部署への分類 | Jev Choice | 選択肢が決まった意味判断のため |
| 障害報告の深刻度評価 | Jev Score | 説明された段階の中での判断のため |
| オペレーターへの接続要求の確認 | Jev Noul | 特定の意図の有無を判断するため |
| 回答の作成や自由な要約 | 生成モデル | 新しい文字列の生成が必要なため |
文字列の出力を処理する際には、形式を検証するコードが必要になることがあります。Jevは定義された答えの形式を直接返す仕組みです。だからといって、すべての検証や再試行が不要になるわけではありません。公式SDKも通信エラーなどに備えた再試行ポリシーを提供しています。
外部入力の検証と業務ルールのチェックは、引き続き分けて設計してください。モデルの答えが型に合っていても、業務上は間違っている可能性があります。この区分は、公式のClient SDKsとモデルの限界に関する文書に基づく設計上の解釈です。
TypeScriptの質問定義と答えの型
TypeScript SDKは質問の定義から戻り値の型を推論します。Choiceの選択肢のキーが、答えとして許される値に結び付きます。その結果、許されていない文字列との比較をコンパイル時に検出できます。SDKに必要な環境はNode.js 20以上です。
次は、公式SDKの呼び出し形式を応用した説明用のコードです。実行結果や正確さを測定した例ではありません。環境変数TYPESAFE_API_KEYの設定が必要です。
import { TypeSafeClient, choice } from "@typesafe-ai/sdk";

const api = new TypeSafeClient();

async function classifyMessage(message: string) {
  const result = await api.systemOne({
    model: "jev-1.13.0",
    state: { message },
    questions: {
      topic: choice("Classify the subject of message.", {
        account: "Account access or password problems",
        delivery: "Shipment tracking or delivery problems",
        other: "Any subject outside those categories",
      }),
    },
  });

  return result.answers.topic;
}
この例のchoiceの型はaccount | delivery | otherです。文字列は実際のTypeScriptでは引用符で表記されるリテラル型です。ただし、型チェックでは問い合わせを正しく分類したかどうかは判断できません。インストール方法と呼び出し仕様はJavaScript SDKの文書で確認してください。